통계 분석
신호처리의 기초 과정의 2번째 주제에 포함된 강의입니다.
통계 분석은 랜덤 변수를 사용하여 해당 변수의 가능한 특성을 전달합니다.
구체적으로는 확률 공간(Ω, E, P)에서 추출된 랜덤 표본을 비랜덤 통계의 관점에서 특성화합니다. 종종 이러한 통계는 기대 연산자 E로 정의됩니다.
기대 연산자는 랜덤 변수에서 2.7 또는 5와 같은 특정 숫자로의 맵을 생성합니다. (Ω, E, P)의 확률 함수 P가 알려진 경우 통계를 분석적으로 계산할 수 있습니다. 그러나 현실 세계에서는 일반적으로 P를 알 수 없습니다. 이러한 경우 다양한 기법을 이용하여 통계치를 추정할 수 있다.
다음은 통계 분석에 대한 몇 가지 시사점입니다.
- 랜덤변수나 랜덤프로세스에 대해 통계분석을 수행합니다.
- 랜덤 변수는 실험 결과를 숫자로 변환합니다.
난수 및 비난수
숫자 형태의 랜덤 변수를 통해 엔지니어는 랜덤 변수에 대해 수학적 연산을 수행할 수 있습니다. 그러나 난수에 대한 수학적 연산은 여전히 난수입니다.
결정을 내리기 전에 엔지니어는 난수를 생성한 기본 물리적 시스템에 대해 알려주는 난수가 아닌 숫자(통계)가 필요합니다. 일반적으로 난수(변수)를 난수가 아닌 숫자에 매핑하는 연산은 기대 연산자 E입니다.
기대 연산자 E
기대 연산자 E는 많은 통계 및 통계 분석의 기초입니다. 확률 변수 X의 기대값 EX는 값이 발생할 확률로 가중된 X의 가능한 각 값의 합입니다.
확률 변수 X의 기대값 EX는 다음과 같습니다.
(1) 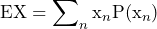
여기서 […, x1, x2, x3, x4, x5, …]는 X와 P(x의 가능한 값입니다.n)는 값 x가n 이 발생합니다.
기대값 EX는 엔지니어에게 X에서 무엇을 기대하는지 알려줍니다.
예
X가 주사위 쌍의 합을 나타내는 확률 변수인 경우 X의 기대값 EX는 다음과 같습니다.
EX = 2(1/36) + 3(2/36) + 4(3/36) + … + 12(1/36) = 7
따라서 우리는 한 쌍의 주사위의 합이 7이 나올 것으로 예상할 수 있습니다.
단일 확률 변수의 순간
기대 연산자를 사용하여 단일 확률 변수 X의 일부 공통 통계 또는 적률을 정의할 수 있습니다.
- X의 n번째 순간은 E[X입니다.n].
- 첫 번째 순간은 평균 또는 μ입니다.
- X의 n번째 절대 모멘트는 E[|X|n]. E[|X|2]는 PSD의 Welch 추정치와 밀접한 관련이 있습니다.
X의 n번째 중심 모멘트는 E[(X-μ)입니다.n].
-
- E[(X-μ)2]는 X 또는 σ²의 분산입니다.
- E[(X-μ)3]는 X의 왜도입니다.
- E[(X-μ)4]는 X의 첨도입니다.
X의 n번째 절대 중심 모멘트는 E[|X-μ|n].
예: 순간 통계
위의 주사위 쌍 예시를 사용하면 다음과 같습니다.
(2) 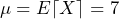
(3) 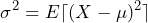
(4) 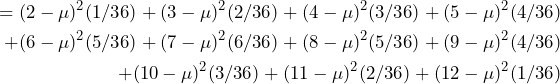
(5) 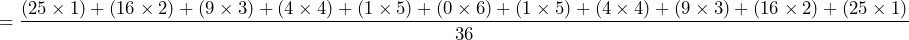
(6) 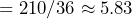
이 예에서 μ 및 σ²는 알려진 확률 함수 P로부터 계산되었습니다. 그러나 대부분의 실제 응용 프로그램에서는 P를 알 수 없습니다. 이 경우 일반적인 해결책은 많은 샘플을 채취하여 그로부터 통계를 추정하는 것입니다.
산술 평균
평균 μ=E[X]를 추정할 때 산술 평균을 사용할 수 있습니다. 표본 x의 산술 평균1, x2, x3, …, xN; 다음과 같이 정의됩니다.
(7) 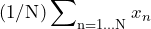
산술 평균이 실제 평균 E[X]에 대한 좋은 추정치입니까? 답은 N의 크기와 샘플을 생성한 장치가 시간이 지나도 안정적인지(프로세스가 광의의 고정식 또는 WSS인지) 여부에 따라 달라집니다.
N이 크고 프로세스가 WSS인 경우 산술 평균은 비공식적으로 E[X]의 좋은 추정값입니다. 예를 들어, 엔지니어는 추정치가 편향되지 않았다고 말할 수 있습니다.
(1/N) 곱하기 N 랜덤 변수의 합은 랜덤 변수입니다:
(8) 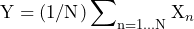
Y의 예상 값은 다음과 같습니다.
(9) 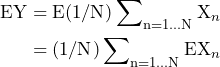
프로세스가 광의적으로 정상적이라면 EXn 모두 동일하며:
(10) 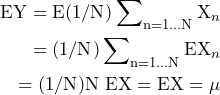
산술 평균의 기대값이 실제 평균입니다. 이는 산술 평균이 실제 평균에 대한 편향되지 않은 추정치임을 의미합니다.
ASK AN ENGINEER
시험 조건을 실제 장비에 적용해 보세요.
시편 정보와 목표 조건을 보내주시면 시험 가능 여부를 검토합니다.